Разработчики получат PDK для Nanostack в первом квартале 2027 года. IBM обещает улучшить масштабирование SRAM на 40%.
IBM назвала срок, когда сторонние разработчики смогут попробовать её 0,7-нм техпроцесс Nanostack. Наборы для проектирования (PDK) станут доступны в первом квартале 2027 года, сообщает Shazoo. Сам техпроцесс компания показала в июне 2026-го.
Зачем это нужно. Без PDK под конкретный техпроцесс микросхему просто не спроектировать. Именно через такие наборы NVIDIA, AMD и другие компании превращают возможности фабрики в реальные продукты. В комплект обычно входят:
скрипты, которые генерируют топологию в EDA-пакетах Cadence, Synopsys и других вендоров.
Ранний доступ даёт инженерам время разобраться с новыми правилами задолго до массового внедрения технологии.
Источник: Shazoo
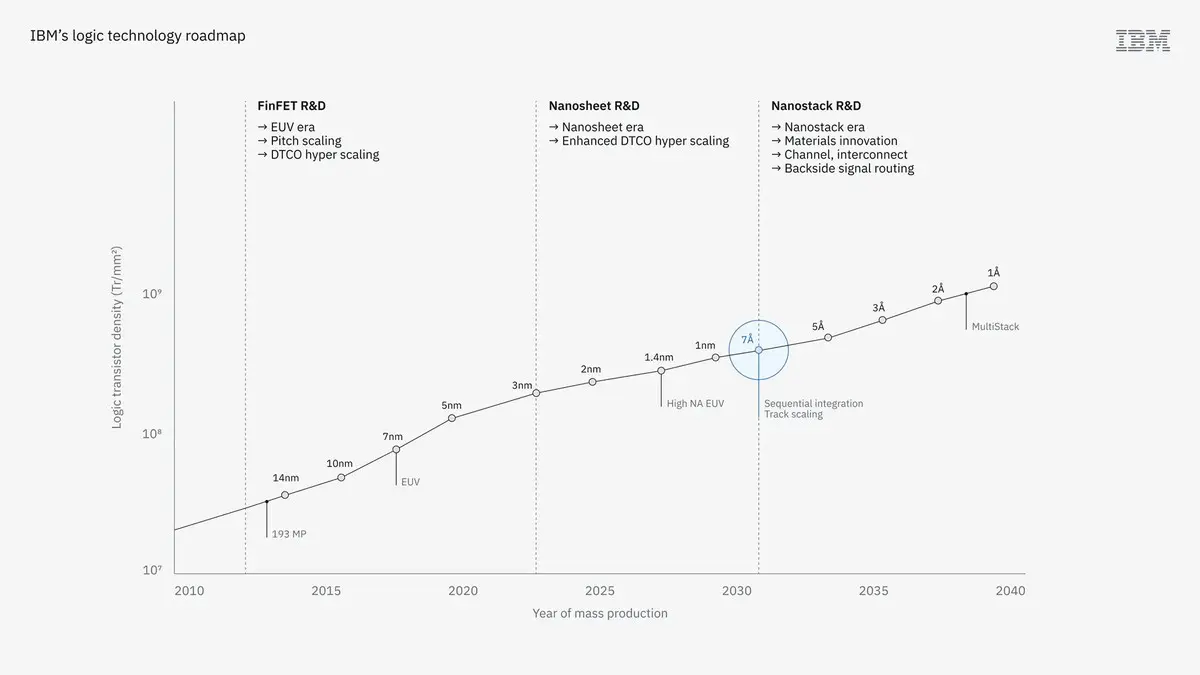
Немного о цифрах. Сейчас самый продвинутый массовый техпроцесс обозначается как 2 нм. Intel и TSMC готовят следующие ступени — 18A, A16 и A14, где «A» означает ангстремы (10 ангстрем — это 1 нм). В этой логике разработка IBM соответствует 7 ангстремам. Правда, цифры в названиях давно стали маркетингом и с реальными размерами элементов транзистора не совпадают.
Транзисторы в стопке
Главная идея Nanostack — вертикальное размещение транзисторов друг над другом со смещением. В отрасли похожий подход развивают под именем CFET (комплементарный полевой транзистор): n- и p-транзисторы не стоят рядом, а складываются в стопку.
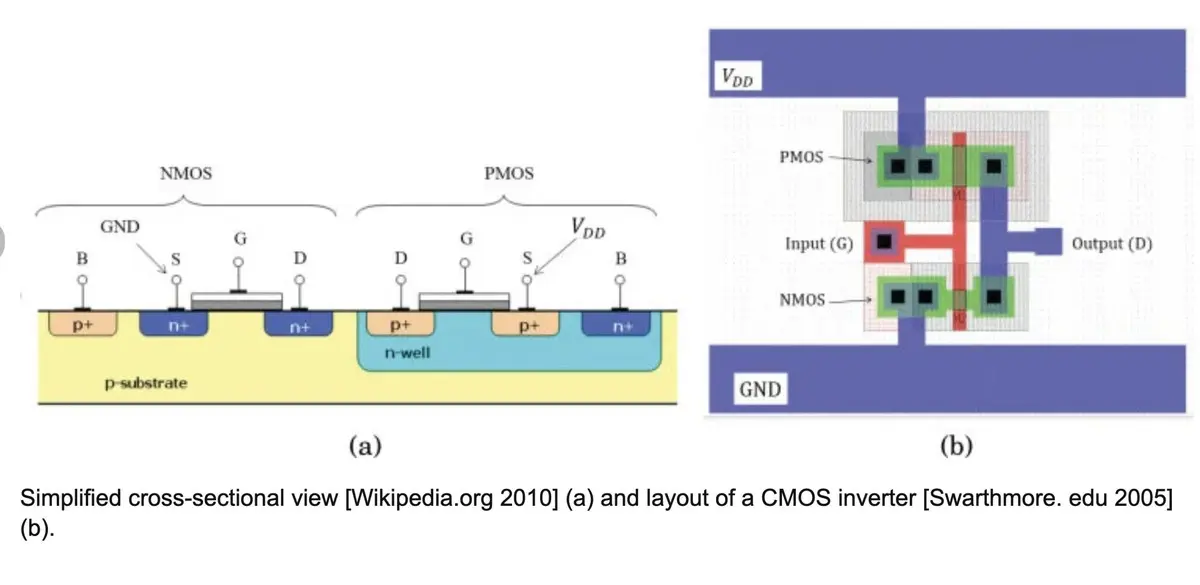
Эта пара лежит в основе КМОП-логики, на которой работает почти любой современный процессор. NMOS-транзисторы проводят ток за счёт свободных электронов и тянут сигнал вниз, PMOS — за счёт «дырок» и тянут вверх. В состоянии покоя один из них всегда закрыт, поэтому постоянного тока нет и чип почти не расходует энергию.
По словам IBM, разнесение n- и p-транзисторов по уровням не только экономит площадь. Кремний для них легируют разными элементами, и раздельное расположение позволяет подбирать новые материалы для каждого типа независимо.
В итоге компания рассчитывает на выигрыш сразу по нескольким фронтам: плотность транзисторов, производительность, энергопотребление и масштабирование SRAM.
Главный козырь — память
Самое интересное обещание — SRAM, которая масштабируется на 40% лучше. Это одна из самых болезненных проблем индустрии.
Логика на 2 нм всё ещё уменьшается и становится быстрее и экономичнее. С памятью сложнее: когда затвор короче 3 нм, растут утечки, теряется энергия, хуже распространяется сигнал. Элементы ячейки SRAM настолько крошечные, что на работу памяти заметно влияют микроскопические колебания концентрации примесей и шероховатость линий. Поэтому вычислительные блоки, включая GPU, от поколения к поколению сжимались, а площадь SRAM почти стояла на месте.
Источник: Shazoo
Для ИИ-ускорителей это ощутимо: встроенный кэш отъедает заметную часть кристалла. По оценкам, в NVIDIA Hopper H100 на SRAM уходит около 10% площади, а вместе с кэшем L1 в потоковых мультипроцессорах (SM) — 12–15%. Если Nanostack выдаст обещанное, производители смогут либо добавить больше кэша на кристалл того же размера, либо сделать ИИ-чипы компактнее. Пока это заявления IBM — проверить их на практике разработчики смогут после выхода PDK.